RTX 30,40 시리즈도 잡혀가게 생겼음
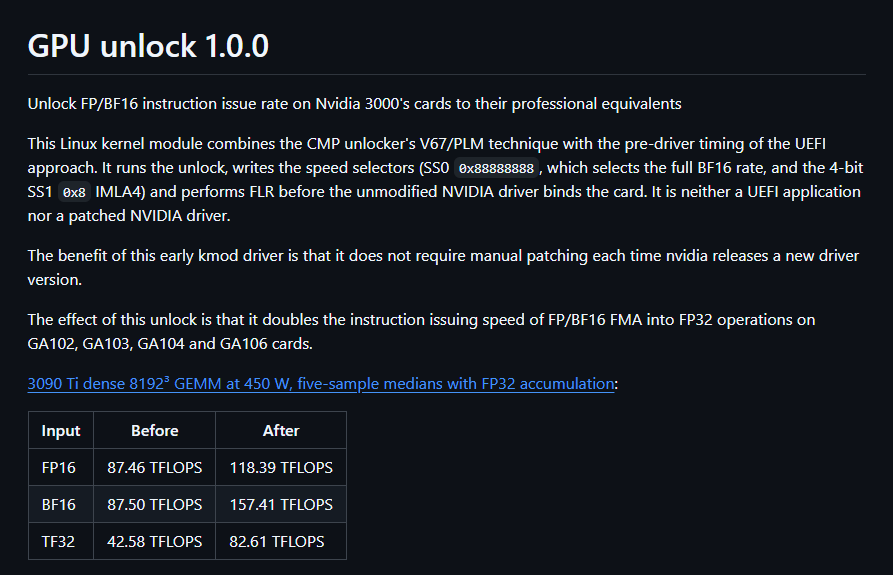
30,40 그래픽카드의 FP16 및 BF16 연산 명령어 속도조절해논걸 풀어버리는 언락커가 나왔음
특히 30번대 카드들은 채굴방지용 LHR카드가 많은데, 해당 기능 작동도 막아버리고 커널단계에서 속도제한을 풀어버리는 기능인듯함.
문제는 저게 따로 vBIOS 플래싱이나 하드웨어 개조 없이 딸각으로 된다라는거임
그결과로
RTX 3090 Ti: BF16 성능이 기존 87.5 TFLOPS에서 157 TFLOPS로 급증 (+80% 향상).
RTX 3080 10GB: FP16 성능이 65 TFLOPS에서 113 TFLOPS로 향상
이라는 거의 2배 가깝게 TFLOPS가 상승하는 매직을 보여주고있음.
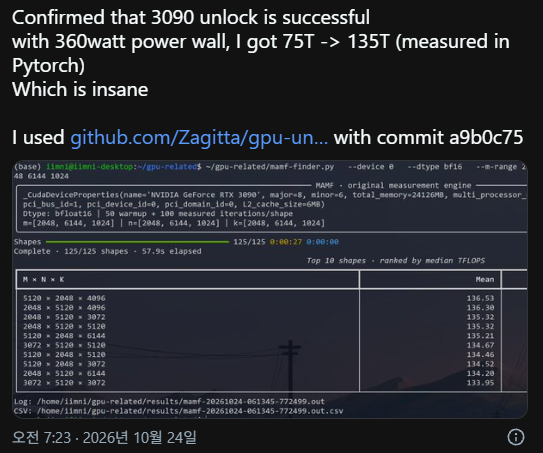
어떤레딧유저는 RTX 3090 24긱을 저걸로 언락하고 최적화해서 Qwen3.8-27B 구동 시 초당 381 토큰을 뽑아냈다고함
(그런데 저거는 구라일가능성이 높긴함. 참고로 5090에 저모델 올리고 돌리면 140토큰이 한계임)
그리고 AD10x 페이로드가 적용되면서 4090부터 4060 Ti까지 전체 라인업의 텐서 코어 처리량 및 FP8 연산 성능까지 두 배로 향상됨을 확인함.
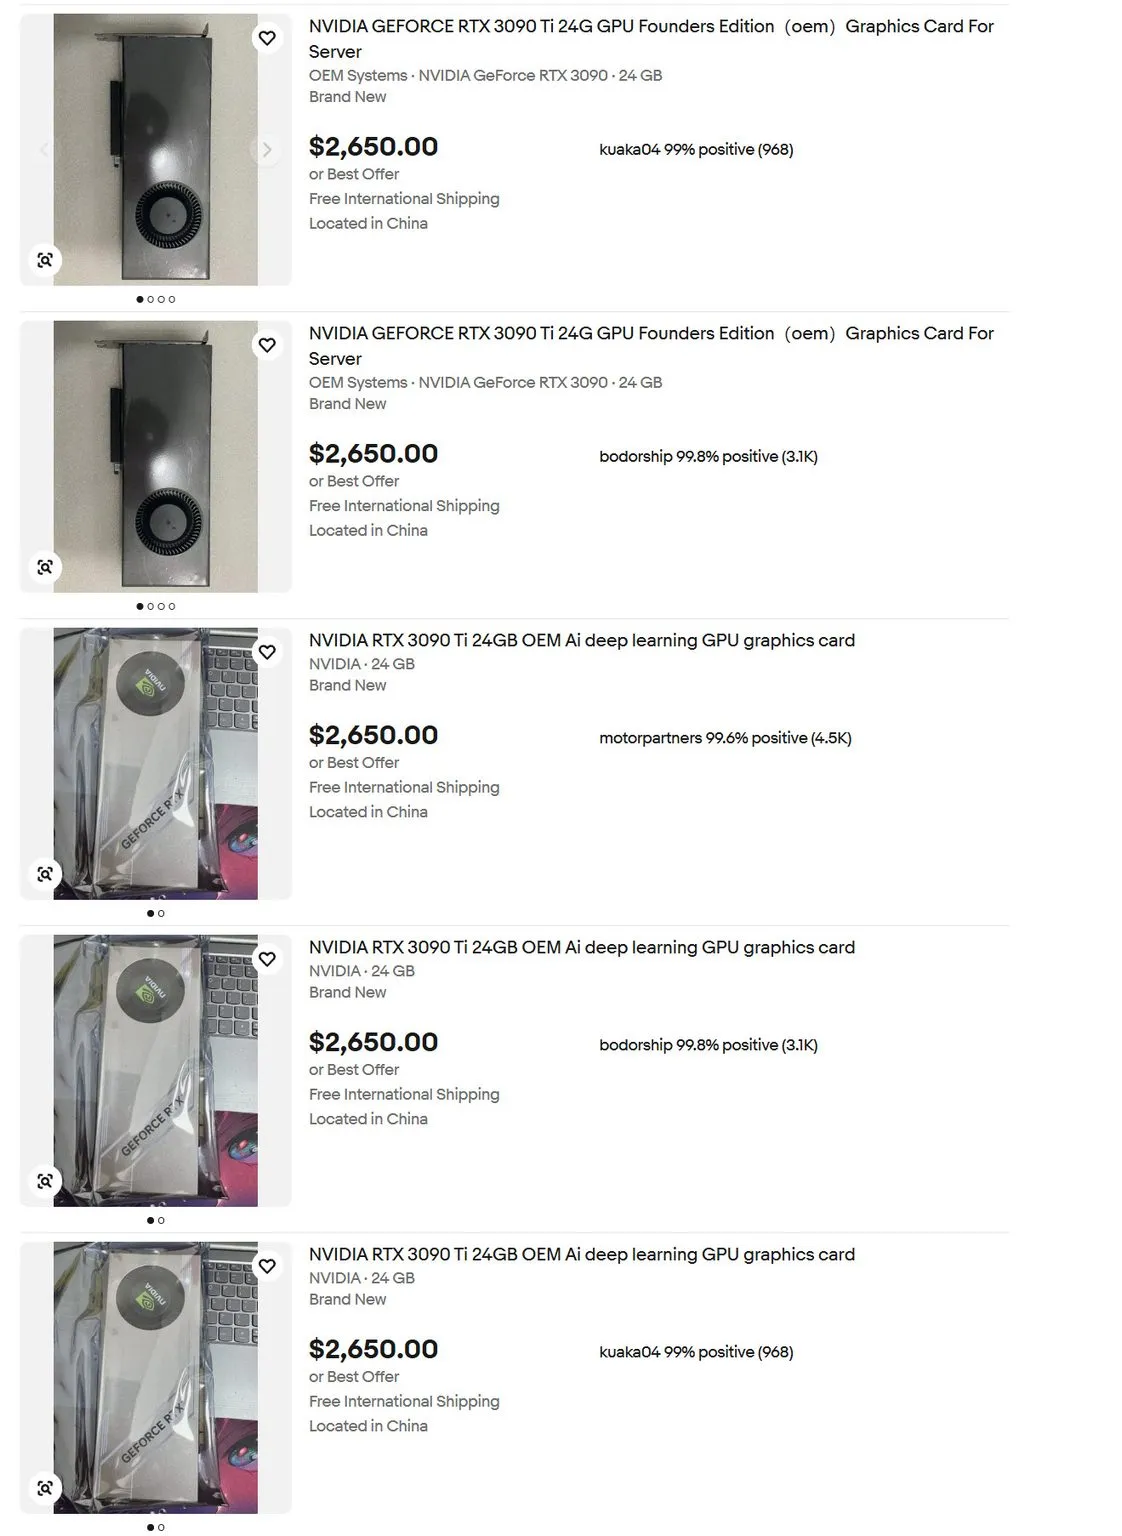
그래서 채굴장 끌려갔다가 살아돌아온 3090,3080 중고시세 개폭등중
한줄요약 : 채굴장에서 살아돌아온 30시리즈들은 제2의 인생으로 토큰머신이 되게생겼음